oBispo

Caruaru, Pernambuco · remoto para todo o Brasil e exterior

Anderson
Bispo

Engenheiro de Dados Sênior · IA aplicada a dados

Construo pipelines de dados em produção, do streaming ao data warehouse, e uso machine learning e IA generativa para transformar esses dados em decisões. Também ensino tudo isso em sala de aula.

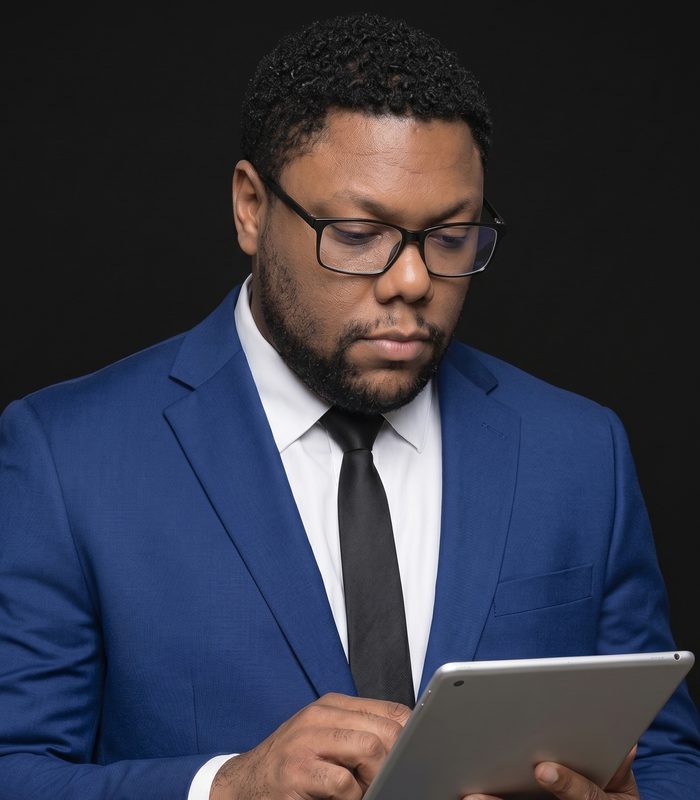
Anderson Bispo de terno azul, consultando um tablet Aberto a novas oportunidades
dag_id="anderson_bispo" successrunning

Selecione uma etapa para ver o log.

O que eu construo

Quatro frentes que se conectam: os dados chegam pelos pipelines, viram análise, alimentam modelos e chegam às pessoas por meio de produtos com IA.

Engenharia de dados

Ingestão em streaming e batch, data lakes, data warehouses e arquitetura em camadas, com orquestração, testes de qualidade e CI/CD.

KafkaAirflowdbtBigQueryDatabricksPySpark

Analytics

Modelagem dimensional, SQL avançado e dashboards que levam indicadores de performance e de negócio para a liderança.

SQLPower BIStreamlitpandas

Machine learning

Modelos preditivos e de NLP validados antes de ir para produção, como manutenção preditiva de aeronaves e análise de sentimentos.

scikit-learnNLPnumpy

IA generativa e LLMs

RAG, agentes e LLMs locais ou via API, com avaliação por especialistas e proteção de dados sensíveis desde o desenho.

RAGpgvectorLangGraphFastAPIClaude Code

Trajetória

Da infraestrutura de redes à engenharia de dados e IA, em ordem cronológica inversa.

    Projetos em destaque

    Arquiteturas de produção, pesquisa acadêmica e produtos próprios.

    Produção · Grupo Aposta Ganha

    Plataforma de dados transacionais em streaming

    Ingestão near real-time de 29 tópicos Kafka com depósitos, saques, saldos e apostas. Os eventos chegam ao data lake em Parquet, são carregados no BigQuery e modelados em camadas com dbt, com deduplicação idempotente, testes de qualidade e deploy automatizado.

    Kafka›Cloud Run›GCS›BigQuery›dbt›Analytics
    AirflowSecret ManagermTLSGitHub Actions
    Código aberto · Case técnico

    Pipeline ELT com modelo estrela

    Pipeline containerizado que leva dados de vendas de uma base operacional para um data warehouse PostgreSQL, com camadas raw, staging e analytics, DAG diária idempotente, 20 testes de qualidade e KPIs em Power BI e Streamlit.

    Ver o código no GitHub
    SQLite›raw›staging›analytics›BI
    Docker ComposeAirflowdbtPostgreSQL
    Pesquisa · Mestrado PPGEC/UPE

    OASIS: RAG longitudinal para apoio clínico

    Pipeline RAG com perfil longitudinal determinístico e prompts dinâmicos para apoiar profissionais que atendem crianças com TEA. Os indicadores são calculados por regras auditáveis, e a avaliação combinou métricas técnicas com a análise de especialistas.

    RAGLLMs locaisPydanticROUGE-LKappa de Fleiss
    Produto · Fundador e CTO

    NeuroKids

    Plataforma SaaS gamificada de aprendizagem para crianças neurodivergentes. Defino a arquitetura de aplicação, dados e IA, com métricas calculadas de forma determinística, relatórios gerados por IA e anonimização em conformidade com a LGPD.

    FastAPIPostgreSQLpgvectorReact NativeNext.js

    Cases de análise de dados

    Projetos completos em três níveis de profundidade. Cada um responde a uma pergunta de negócio, mostra como foi resolvida e o que os dados revelaram, com pipeline reprodutível, testes automatizados no GitHub Actions e dashboard publicado. Clique na imagem para abrir o dashboard.

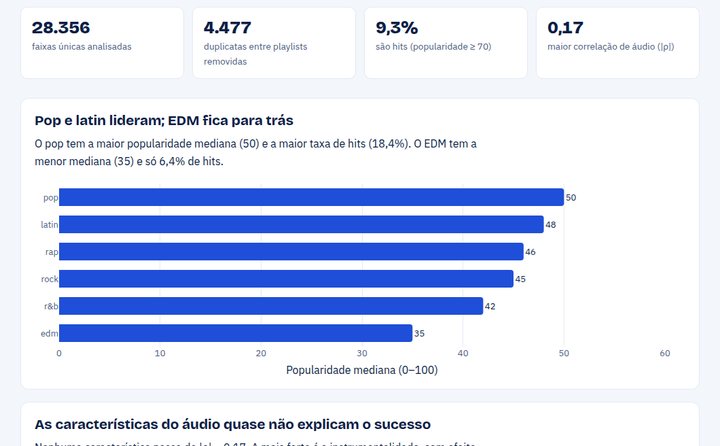
    Dashboard de popularidade do Spotify: KPIs e popularidade mediana por gênero Bronze · análise exploratória

    O que faz uma música ser popular no Spotify?

    Problema
    Onde uma curadoria de playlists deve investir espaço e divulgação.
    Solução
    28 mil faixas deduplicadas em SQL, correlação de Spearman e análise por gênero e subgênero.
    Resultado
    O áudio quase não explica o sucesso (|ρ| ≤ 0,17); o subgênero separa de 27 a 65 de popularidade.
    DuckDBpandasPlotlypytest
    13 testes · CI no GitHub Actions
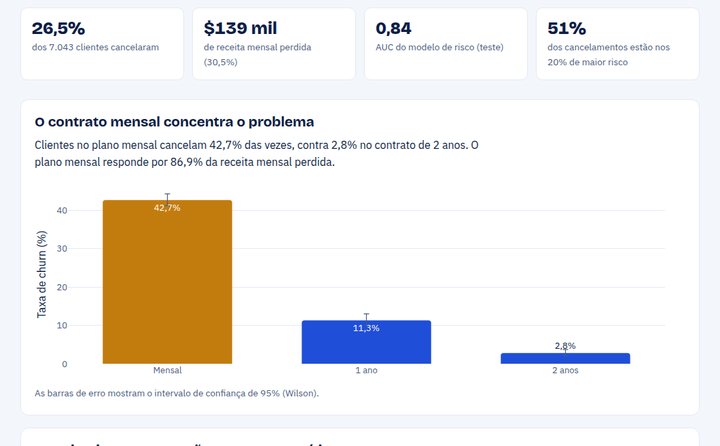
    Dashboard de churn: KPIs e taxa de cancelamento por tipo de contrato Prata · SQL, Python e diagnóstico

    Quem cancela e como antecipar o churn

    Problema
    Uma operadora perde 26,5% dos clientes e 30,5% da receita mensal.
    Solução
    Segmentos com intervalo de confiança, ranking de fatores e score de risco com regressão logística.
    Resultado
    AUC de 0,84; os 20% de maior risco concentram 51% dos cancelamentos.
    DuckDBscipyscikit-learnpytest
    7 testes · CI no GitHub Actions
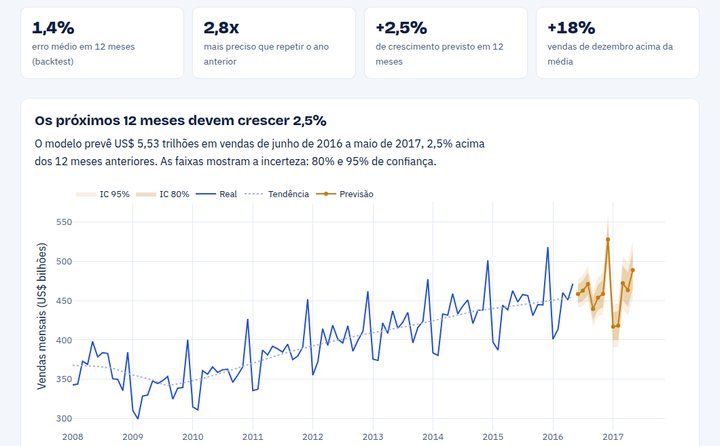
    Dashboard de previsão: KPIs e histórico com previsão de 12 meses e intervalos de confiança Ouro · séries temporais e previsão

    Quanto o varejo vai vender nos próximos 12 meses

    Problema
    Planejar estoque, equipe e caixa para o próximo ano.
    Solução
    Decomposição STL e três modelos comparados em backtest com origem móvel.
    Resultado
    SARIMA com erro médio de 1,42% em 12 meses, 2,8x melhor que a base; +2,5% previsto.
    DuckDBstatsmodelsPlotlypytest
    7 testes · CI no GitHub Actions

    No GitHub agora

    Os repositórios atualizados mais recentemente, carregados direto da API do GitHub.

    Stack

    Linguagens

    • Python
    • SQL
    • PySpark

    Pipelines

    • Airflow / Cloud Composer
    • dbt
    • Kafka

    Cloud e plataformas

    • GCP (BigQuery, Cloud Run, GCS)
    • Databricks
    • AWS

    Bancos de dados

    • PostgreSQL e pgvector
    • SQL Server
    • Snowflake

    IA e ML

    • scikit-learn
    • RAG e LangGraph
    • LLMs locais e via API

    Entrega

    • Docker
    • GitHub Actions
    • Git

    Vamos conversar

    Estou aberto a oportunidades remotas em engenharia de dados, analytics e IA, no Brasil e no exterior.